
建一座AI工厂,按英伟达官方口径,每兆瓦约6000万美元,吉瓦级项目就是约600亿美元的资本开支,如同修一座大型电站。当地时间上周四,英伟达在博客里给出这类“大型电站”的回报公式:产出、寿命、需求。
当前市场上多数玩家,还在按“买IT设备”的老办法来计算AI工厂的资产价值:三五年计提折旧,到期减值,残值按零处理。至于这座“工厂”一年能产出多少、设备能运转多少年、产出能不能卖掉,这些真正决定回报的问题,在采购环节很少有人提及。
英伟达想把这套新的AI工厂资产计算公式推给整个市场。今年8月,它与Apollo、贝莱德、黑石、博枫、高盛、KKR六家机构宣布共建融资平台(目前仅为合作备忘录,尚无交易签约),计划撬动超过5000亿美元的第三方资本投入AI基础设施,算力第一次被信贷市场按基础设施而非设备定价。
而这其中,空头的读法正相反,Michael Burry认为前沿芯片的实际寿命只有两三年,折旧拉长掩盖的是透支的需求。
电站的估值公式
英伟达把AI工厂的回报归结为三个变量:盈利能力(满负荷运转一年能卖出多少token)、使用寿命(硬件保持产出的年限)、需求(这些token究竟能卖出多少)。熟悉基础设施投资的人对这套语言并不陌生。电站、油田、船舶的估值,用的正是同一个公式:单位产出、资产寿命、负载率。
三个变量相互牵制,无法互补。按博文的说法,盈利能力再强,若只能卖出一半产能,也无济于事;需求再旺,若设备一年后就跑不满,同样无效。投资一座AI工厂,等于对三个变量同时下注,押错任何一个,另外两个做得再好也无法弥补。
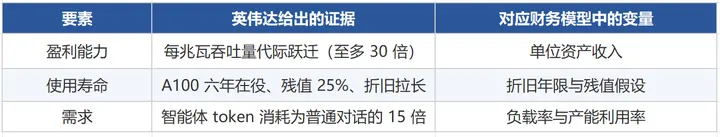
算力资产估值三要素一览
三个变量里,先看产出。
评估电站,行业看度电成本;评估AI工厂,对应指标是每秒每兆瓦token数。电力是建厂绕不开的硬约束,能耗指标、变压器容量、并网排队,在每个市场都是最稀缺的许可。在固定的电力包络里,产出的token越多,单位电力的收入就越高。
两代设备之间的产出差距,已经不是百分比能形容的。据SemiAnalysis AgentX基准(回放真实智能体编码会话测算),在DeepSeek V4-Pro负载、每用户每秒160 token的条件下,Vera Rubin NVL72每兆瓦吞吐量较上一代GB300 NVL72高逾30倍,每百万token成本至多低45倍;GB300较H200机群每百万token成本又至多低10倍。厂房和电力指标不变,吞吐量在代际之间相差两个数量级。
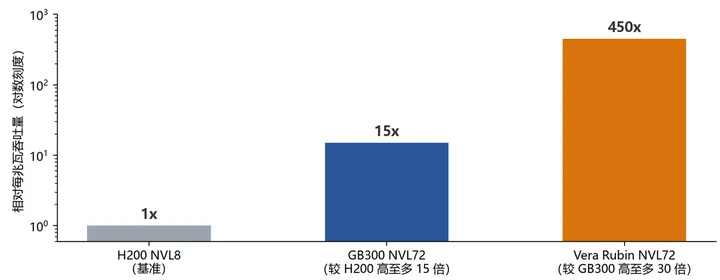
每兆瓦吞吐量代际对比(对数刻度)。口径:SemiAnalysis AgentX,DeepSeek V4-Pro 智能体编码负载,特定条件下的至多值
这些增益并非主要来自制程的线性进步,而是更多来自从模型、编译器、推理框架到计算、网络、内存的全栈协同设计:MoE服务运行时、低精度数值格式、KV缓存复用、预填充与解码分离调度,每一层都在为“每兆瓦token数”服务。芯片可以对标,全栈难以复制。
效率提升自然会引出一个担忧,token越来越便宜,需求会不会被自己消减掉?
市场数据恰恰相反,据OpenRouter统计,单个智能体请求消耗的token是普通聊天的15倍,平均提示token已增长约四倍。一个做投资研究的智能体,会查数据库、读财报、调用子智能体做横向比较,再综合成结论:token的消耗随任务复杂度增长,而不再随对话轮数封顶。
降价释放的空间,正被智能体的消耗重新填满。这是杰文斯悖论在算力市场的又一次应验。
使用寿命:会计与市场的分歧
效率回答“每一兆瓦能赚多少”,资产的另一半答案是“能赚多少年”。使用寿命是三个变量里口径最分裂的一个:在资产负债表上,它由会计政策决定;在现实中,它由物理衰减和市场需求共同书写。两套口径的差距,正越拉越大。
以A100为例,A100发布于2020年,六年后仍在商业服役;CoreWeave把2020年批次的机器一直预订到2029年,一台2020年的芯片,收入周期接近九年。多年期合同,是运营商为“旧机器还能持续产出”付出的实际代价。
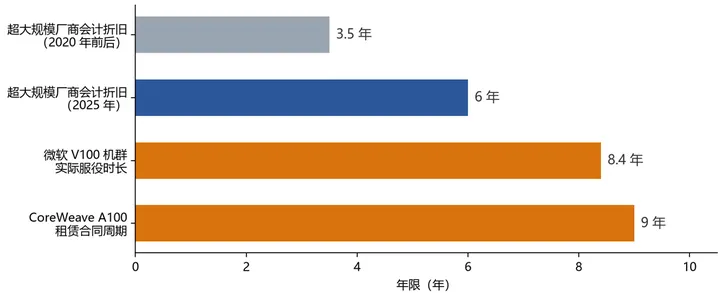
会计折旧年限与实际服役时长。来源:Sprout(2026 年 9 月)、Introl 汇总及公司披露
个案之外,行业整体的会计政策也在调整。据Sprout 2026年9月报告,超大规模运营商已将服务器会计折旧从三四年普遍拉长到六年;据Introl等第三方汇总,这一调整合计每年减少折旧约180亿美元,相当于给全行业多出同等规模的账面利润。微软在2022年把服务器折旧年限从四年延长到六年,估计使其2023财年营业利润增加约37亿美元;微软的V100机群账面六年,实际跑了8.4年。
市场的定价提供了另一重参照。Silicon Data的数据显示,发布六年的A100在二手市场仍能卖到原价的四分之一;Ornn Data的租赁指数显示,它的五年期长租价格约为一个月租约的八成。一座按五年折旧就该“一文不值”的资产,市场上仍有人愿意出价。
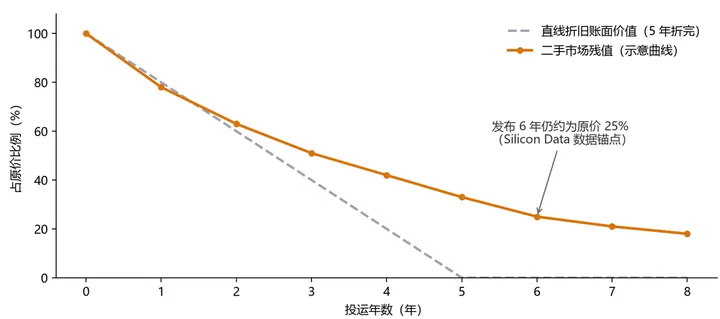
A100 会计账面价值与二手市场残值对比。残值为示意曲线,锚点数据来自 Silicon Data(六年约 25%,单卡口径;Sprout 测算系统级残值更高,为原价的 38%—43%)
通用性,和一个未曾言明的赌注
资产寿命的长短,一个关键变量是它能处理的负载有多少种。为单一负载定制的算力,赌的是需求永不迁移:算法一次换代,专用资产可能整体报废;通用平台面对需求波动,只需把算力转去处理其他负载。
专用算力并不罕见,比特币矿机就是一例。芯片为一种哈希算法定制,算法之外没有用途,行情回落时只能按废金属价格处置。同期的以太坊矿工用的是通用GPU,2022年以太坊转向权益证明机制后,这批卡大量转入游戏和推理市场,残值远高于矿机。英伟达的GPU属于后一类,它的通用性来自架构和生态两层。
架构层面,语言、视觉、生物、仿真、图形,这些负载的底层都是大规模并行计算,本就在GPU的能力范围之内;在可编程架构内嵌入Transformer引擎等专用单元,又兼顾了运行效率。生态层面,1000多个CUDA-X库和约1000万开发者,让新负载出现时有现成的软件栈可用,不必从零适配。
Pinterest在14000块GPU上跨Blackwell、Hopper及更早架构混合调度训练与推理,新任务持续落在旧架构上;德州农工大学超算跨26个项目、7家机构,利用率维持在95%—98%;礼来在自己的千卡级本地集群上,同时承载制药模型与内部智能体。
通用性由此转化为资产寿命。但这一切成立的前提,是过去两年算力始终稀缺。
坚挺的残值、满负荷的利用率,究竟是资产本身优秀,还是仅仅因为供不应求?空头Michael Burry去年11月估算,超大规模厂商2026—2028年的折旧被低估约1760亿美元(个人估算,未经证实),前提是前沿GPU的实际经济寿命只有两三年。
他引用的事实与英伟达并无二致,结论却截然相反。在他看来,折旧拉长掩盖的是透支的需求。英伟达随后向分析师发出长篇备忘录反驳,称客户实际按四到六年折旧,A100至今仍在高负荷运转。亚马逊在2025年初把部分服务器折旧年限从六年缩回五年,理由是AI硬件迭代加速,按其2025年报口径,全年多提折旧约14亿美元。
英伟达与空头用的是同一套数据,究竟哪种更接近真相,要看未来两年供给与需求的赛跑。倘若新一代供给放量、需求增速放缓,二手价格和长租折价会最先转向。
无论英伟达的叙事成色几何,这套估值框架本身值得被认真对待,尤其对正在大规模建设智算中心的中国市场而言,三要素恰好对应三个悬而未决的问题。
最直接的问题留给云厂商与智算中心:折旧年限定在哪。从国内运营商年报的折旧政策看,多按四五年计提。若资产实际寿命八年以上,当期利润就被系统性低估,项目回报被看错;若需求根本撑不满设备的一生,问题就不在会计,而在经营。要回答这个问题,得翻各家财报的折旧政策和利用率数据:是会计口径的问题,还是经营的问题,修正方向截然相反。
折旧之外,投资者还需要注意运营商调整折旧年限的公告(管理层对资产寿命的真实判断往往先出现在这里)、二手GPU交易与长租价格(残值的独立参照)、新代际发布后旧型号的租金变化(需求端的读数)。不过国内市场目前还缺少公开、连续的二手算力价格数据,这些信号大多只能从运营商公告和海外数据商处间接获得。
产业政策层面,算力重资产化之后,土地、电力指标、能耗审批已经成为实际的市场准入门槛。评价一座智算中心,标准应该从装机规模换成“每兆瓦产出”:前者衡量资产质量,后者只统计数量。
高效、耐用、通用。英伟达用三个词宣告算力进入“资产时代”:它有了估值公式,有了残值曲线,也开始有了自己的融资渠道。这套叙事能否立住,要看未来两年供给与需求的赛跑。10月21日,黄仁勋将在GTC柏林发表主题演讲,Vera Rubin的量产节奏与AI工厂参考设计,会给出这场赛跑的下一组数据。(本文首发钛媒体APP,作者 | 硅谷Tech-news,编辑 | 焦燕)
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App