
本文来自微信公众号: 赛格大道 ,作者:叙夷
尽管英伟达最早推出“超节点”AI算力集群架构,但华为在这条路上显然走得更坚决也更远。
10月6日,在华为全联接大会的媒体沟通会上,徐直军说了25.6万这一个数字,这不是金额或人数,而是加速卡的数量。
目前,华为正在部署和测试一个由25.6万张昇腾卡组成的Atlas 950超节点集群。英伟达把72张GPU连成一个NVL72机柜,被视为机架级架构的代表作;但华为要连起来的计算集群,是这个数量的3500多倍。
很多人听到超节点,第一反应是“卡多”,但真正的挑战不在这里,徐直军提醒道:更难的在于让数千、数万颗处理器像一台计算机那样工作。
据华为介绍,新发布的计算架构Peerium能让百万颗处理器成为一台计算机。
几乎同一时间,太平洋东岸完成了两笔交易。9月28日,AMD宣布以约82亿美元、全股票的方式收购李飞飞创办的World Labs,交易预计年底前完成,李飞飞将出任AMD执行副总裁兼首席科学家,直接向苏姿丰汇报。
而在9个月前,2025年12月24日,英伟达也曾以约200亿美元的非排他性许可,拿到推理芯片公司Groq的LPU技术授权,创始人乔纳森·罗斯带队加入英伟达,情况颇为相似。
两件事看似并无瓜葛,但如果引入芯片与模型的协同关系,就可以发现,一边试图用现有芯片创造极致效用,另一边则通过模型发展反向指引下一代芯片方向,双方阶段有差异,但战场是同一个。
海外买的不是芯片,是方向感
引人瞩目的AMD收购李飞飞公司一案,在笔者看来,这82亿美元花在哪里,值得拆开来看看。
World Labs成立于2024年4月,李飞飞与几位联合创始人一起做空间智能,研究怎么让机器理解三维世界。这家公司不做通用大模型,团队规模也不大,82亿美元的价格很难用“买一个模型”来解释。
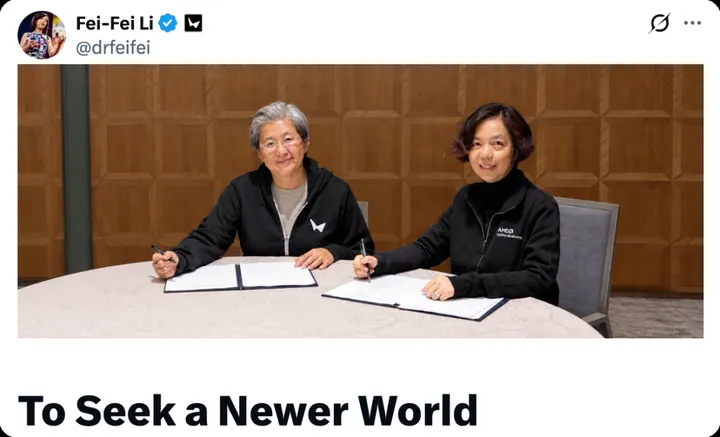
官宣后,苏姿丰表示,“我们的雄心是定义AI计算的未来”,期待将World Labs在AI和世界模型领域的积累,与AMD的计算能力结合起来。
AMD给出的逻辑其实很朴素。它卖的是CPU、GPU和数据中心系统,需要在三五年前就决定下一代产品该长什么样。决定芯片长什么样,最终是未来模型要跑什么样的计算。世界模型、物理AI这类研究,恰恰处在下一代工作负载的源头。把这支团队放进公司,等于在路线图前面装了一个提前量。
英伟达那笔交易是同一个逻辑的另一面。Groq做的是LPU,一种专为推理设计的芯片,用SRAM替代HBM,用确定性执行替代概率性调度,代价是容量和通用性,回报是极低的延迟。
2024年初,它靠每秒几百个token的演示一夜出圈,但商业化始终没跑通规模。2025年9月融资时估值69亿美元,之后英伟达来了:非排他性许可,200亿美元,拿走技术授权和核心团队,公司继续独立运营。
两笔交易方向不同,落点一致。AMD纵向往技术源头走,英伟达横向往推理边界走,其目标都是对下一代计算需求的前置理解。用一句最简单的话概括:先弄清楚未来的模型要算什么,再决定芯片怎么造。
超越单卡限制
当对手驶向无人区,华为需要先做好基本面。徐直军表示,由于无法使用最先进制程,华为单颗芯片与英伟达存在差距。
外界测算的数字大致是:昇腾910C单卡FP16算力最高约800 TFLOPS,约为H200的一半;下一代960DT预计2027年一季度交付,FP8算力约二PFLOPS,基本追平H200,但只有B200、B300这一代的几分之一。而等到那时,英伟达又会推出更新的产品。
单卡差一截,追赶就只能从系统层面做文章。这就是超节点。
2025年华为全联接大会上,徐直军还表示,“我们单颗芯片与英伟达是有差距的,但是长期投入连接技术,我们构筑的超节点,可以做到世界上最强”。
CloudMatrix 384是第一个被广泛讨论的产品:384颗昇腾910C,用全对等互联连在一起。按华为公布的口径,这套系统的BF16算力达到300PFLOPS,综合性能是英伟达GB200 NVL72的1.7倍,总内存是它的3.6倍。SemiAnalysis在报告里给出了那句被媒体和短视频大肆宣传的评价:华为用系统方案弥补了芯片差距。
Atlas 950 SuperPoD把这个思路推得更远。8192张昇腾950DT,128个计算柜加32个互联柜,共160个机柜,占地约1000平方米。华为给出的对比是:相对于英伟达2026年下半年上市的NVL144,卡规模是它的56.8倍,总算力6.7倍,内存容量15倍,互联带宽62倍。
英伟达方案并非毫无软肋,比如把互联分成柜内和柜间两层,最新一代NVL72柜内带宽每秒1.8TB,一出柜就降到每秒0.2TB,相差九倍。所以,要把百万颗处理器当一台计算机用,柜间这个带宽根本不可能满足需求。
华为以灵衢总线作为回应,即用一套统一协议把CPU、加速器、内存、硬盘、网卡和交换机连起来,柜间带宽最高做到每秒800GB,协议转换的时延压到一百五十纳秒量级,而传统方案从柜内网络切到柜间网络,至少要花掉微秒级的时间。
由此可见,英伟达在单卡优势巨大的情况下,无需过度依赖超节点,而华为则把超节点路径推向了极致,这是一种勇气,也是一种无奈。
昇腾超节点能做什么?
判断超节点这条路走到哪一步,最可靠的依据不是参数表,是时间表。
昇腾950系列按场景分成两个型号。面向推理的950PR,2026年第一季度已经发布上市,但徐直军自己说,上市量不算大。基于950DT的Atlas 950超节点,主要面向训练,目前仍在测试,规模供货要等到今年年底或者明年年初。预计从明年开始,中国才会有大量模型训练构筑在950DT超节点上。
换句话说,中国最强的国产训练系统,此刻还在部署和测试之中,距离成为前沿实验室的主力,还有一个明确的交付周期。
这不完全是节奏问题,背后有结构性原因。
因为,推理和训练是两种脾气完全不同的负载。推理相对确定,可以切分,可以调度,卡多了就是吞吐大,超节点的能力能直接兑现。训练是全局同步的,每一步梯度更新都要等最慢的那一张卡,对互联延迟、数据一致性、故障恢复的敏感度极高。规模越大,等待越容易变成吞掉算力的黑洞。
现实层面的印证也很清楚。浪潮人工智能研究院2026年一季度的监测数据显示,全国智算中心GPU平均利用率约30%。国产GPU厂商沐曦在招股书里写明,互联网企业采购国产芯片主要用于推理侧。
DeepSeek的情况更具代表性:V4的预训练仍然在英伟达H800、H100集群上完成,昇腾承担的是推理部署,以及V4-Flash这一档的后训练。
10月2日,DeepSeek开源了面向昇腾的全套训练工具链,与英伟达版本一一对应,这意味着代码层面已经可以在昇腾上跑训练,而计划部署在乌兰察布的16万颗950DT芯片,也主要承担推理任务。
所以更准确的说法是:国产芯片大量落在推理场景,不完全是选择所致,也是能力边界所致。超节点先接住的是推理,这是它目前最扎实的战果。
超节点路径的约束
如果超节点只是把单卡的问题变成了系统的问题,那它至少解决了问题。麻烦在于,它同时制造了三个新的约束。
第一个是产能,这也是最硬的一个。余承东近期在华为国际媒体圆桌会议上,罕见承认:中国先进半导体产能仍然紧张,手机芯片和昇腾AI芯片都要争这块产能,现阶段仍靠DUV光刻。
徐直军表达了类似意思:目前昇腾满足国内市场需求还远远不足,所以没有拓展海外市场的计划,制约供货的不是需求,是产能。他预计全球AI基础设施的供需平衡大约要到2029年才能解决,中国可能还要慢一点。
这里藏着超节点路线最深的悖论。单卡性能越弱,凑出同等有效算力需要的卡就越多,对先进制程产能的需求反而被放大。用系统能力换单卡性能,代价是消耗更多芯片,而芯片恰恰是最紧的那一项。超节点缓解了性能约束,同时把产能约束顶得更紧。
第二个是有效算力。决定训练速度的从来不是峰值算力,而是模型浮点运算利用率,也就是MFU,以及有效训练时长占比。字节在2024年公开的MegaScale系统,在12288块GPU上训练1750亿参数模型,MFU做到55.2%。这个数字的含义是,即便在成熟系统上,也有接近一半的算力在等待、通信和空转中消耗掉了。卡数越多,单卡故障的概率越高,一次中断就可能让数天的训练作废,断点续训、故障自愈、节点替换这些工程能力,直接决定迭代速度。
事实上,国产厂商已经把这件事摆到台面上:摩尔线程公布的夸娥集群数据里,Dense模型MFU达到60%,MoE模型40%,有效训练时长占比超过90%。这些指标成为卖点本身,说明它们曾经是痛点。
第三个是电力和成本。按照市场流出的最低报价,一颗昇腾950DT约11.1万元,25.6万张卡对应的芯片采购就接近284亿元。英伟达NVL72机柜售价约300万美元,折合单卡约4.2万美元,是昇腾的四倍左右;但按FP8峰值算力口径,一颗B200大约抵得上四到五颗950DT。也就是说,昇腾的单价便宜到四分之一,性能却只有四分之一略多,便宜的幅度没有追上性能缩水的幅度。
如果要凑出同等规模的峰值算力,昇腾需要约4.5倍的卡数。卡数乘以4.5倍,机房面积、液冷、运维和人手跟着乘以4.5倍,电力账单也是如此:按NVL72每卡约1.67千瓦的配套功耗反推,25.6万张昇腾卡大致对应380兆瓦级的供电需求,在西部电价下一年约10亿元电费,同等算力的英伟达方案约95兆瓦、2.5亿元,相差四倍。
模型与芯片:谁迁就谁?
把中美两条路放在一起看,最本质的差别不在技术,在方向。
美国的模式是芯片迁就模型。模型定义需求,芯片跟进定制。谷歌的TPU配合Gemini,亚马逊的Trainium配合Anthropic,都是这个逻辑。AMD和英伟达那两笔收购,只不过把这个逻辑往前推了一步:与其等模型公司提出需求,不如把提需求的团队直接买进来。
中国的模式在很多环节上是模型迁就芯片。DeepSeek在V3.1采用UE8M0 FP8数据格式,公开说明是面向下一代国产芯片设计的,模型方主动改自己的数值格式去适配硬件。昇腾超节点本身也是这种迁就的产物,正因为单卡不够,集群才必须做到这个规模。10月2日那套开源的昇腾训练工具,是迁就的另一面:把自己的底层计算程序在另一种架构上重写一遍,换取代码层面的可迁移。
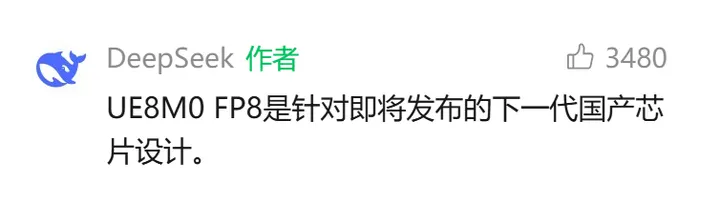
DeepSeek的官宣消息
这也就回答了开头设置的问题:为什么美国正在进行的“以模型反哺芯片”路径,在中国难以复制。这不是意愿问题,而是限制条件完全不同。在算力不紧缺的地方,芯片有动力追着模型跑;在算力紧缺的地方,只能模型绕着芯片走。
当然,迁就不等于一定落后。UE8M0 FP8、灵衢总线、全光互联,都是实打实的工程创造,某些环节华为确实做到了领先。只是这些创造服务的目标是补齐短板,而不是定义下一个时代的计算形态。
对大模型的参赛者而言,路线之争最终会归结为两个变量:性能与成本。超节点在性能一侧给出了自己的答案,真正的考验在成本一侧:单卡越弱,需要的卡越多;卡越多,产能、电力与折旧的压力越重。
25.6万张卡是一个惊人的工程数字,但它真正的含义是,中国要用比别人多得多的卡,去换一个同样好的模型。这个换算率能否降下来,决定了超节点能否从“能用的算力”变成“用得起的算力”,也决定了能否真正托起国产前沿模型的持续迭代。