
本文来自微信公众号: 字母榜 ,作者:袁心玥
这个十一,国内的大模型似乎也放了个长假。
DeepSeek、智谱、月之暗面、MiniMax、阿里、字节、腾讯……几家平时你追我赶的模型厂商,难得集体安静了下来。
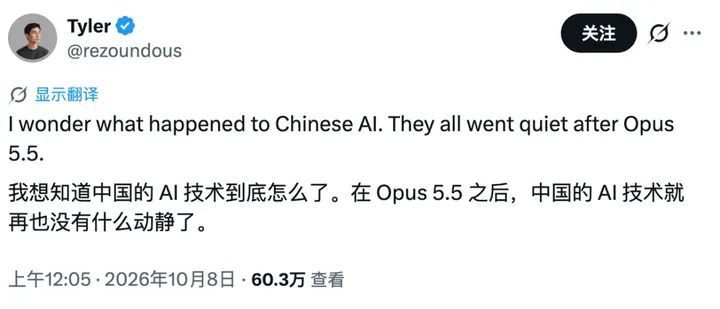
整整七天不见熟悉的跑分大战和价格战,甚至就连海外网友都发出疑惑:中国模型怎么没动静了?
大洋彼岸倒是依旧热闹。
OpenAI刚在DevDay上扔出20多项更新,10月4日又宣布开启为期28天的连续更新;Anthropic也没闲着,10月7日推出Haiku 5.5,补齐了Claude 5.5模型家族。
当然,模型公司并没有全年无休的义务,十一放假本来是再正常不过的事情。
但之前的长假可不是这样。去年十一前后,几家大厂还在扎堆更新模型;今年春节更是热闹,连除夕都没能让模型发布停下来。
相比之下,今年十一简直安静得有些反常。
难不成,国内的AI工程师都放假了么?
发个模型好过节,似乎已经成为了某种心照不宣的默契。
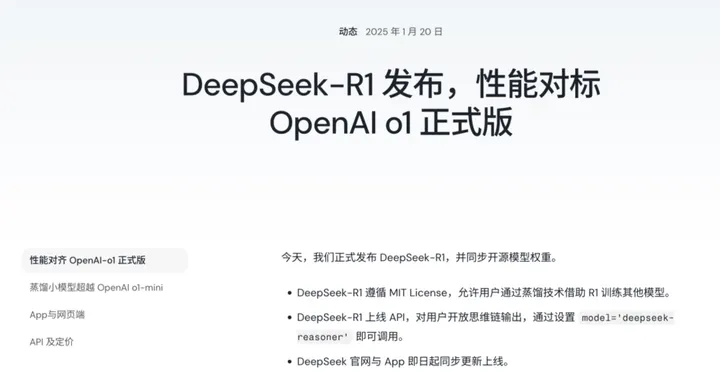
去年1月20日,DeepSeek赶在春节前发布R1,直接掀起了一场席卷全球AI圈的热潮。模型权重和技术报告一起开源,开发者忙着部署、测试,各家云厂商忙着接入,整个AI圈都跟着加班。
1月28日,恰逢除夕,阿里又突然发布Qwen2.5-Max,正面加入这场模型竞赛。
从此,长假也成了大模型厂商争相上新的热闹档期。
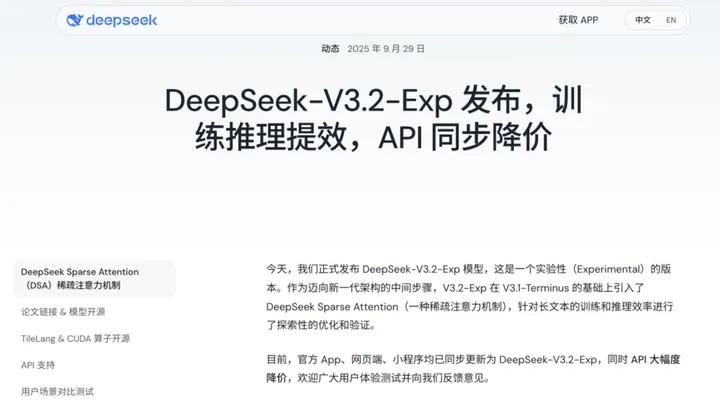
到了十一,去年9月29日,DeepSeek又赶在假期前发布了V3.2-Exp,引入稀疏注意力机制DeepSeek Sparse Attention,重点解决长上下文推理的效率问题,同时大幅降低了API调用价格。
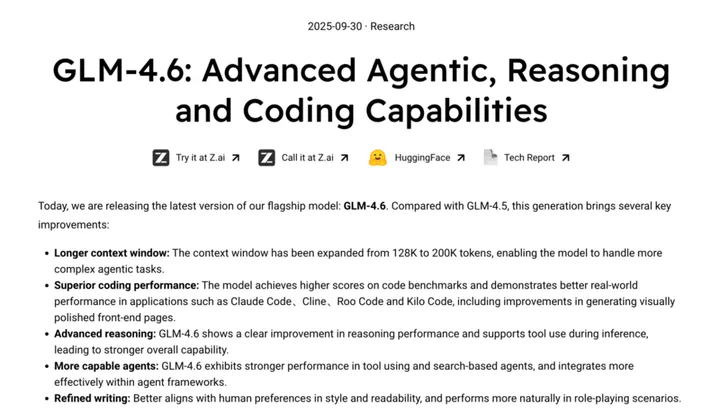
一天之后,智谱紧跟着推出GLM-4.6,把上下文窗口从128K扩展到200K,重点加强了编程、推理和Agent能力。
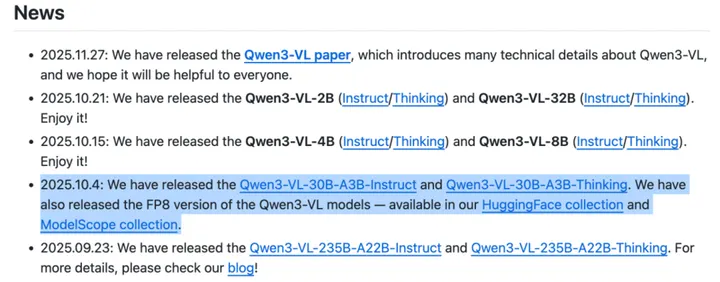
阿里Qwen团队9月23日刚发布Qwen3-VL系列235B旗舰模型,又在10月4日开源了30B-A3B的Instruct和Thinking两个版本,并推出了FP8量化版。十一也没闲着。
论热闹,今年春节还要更胜一筹。
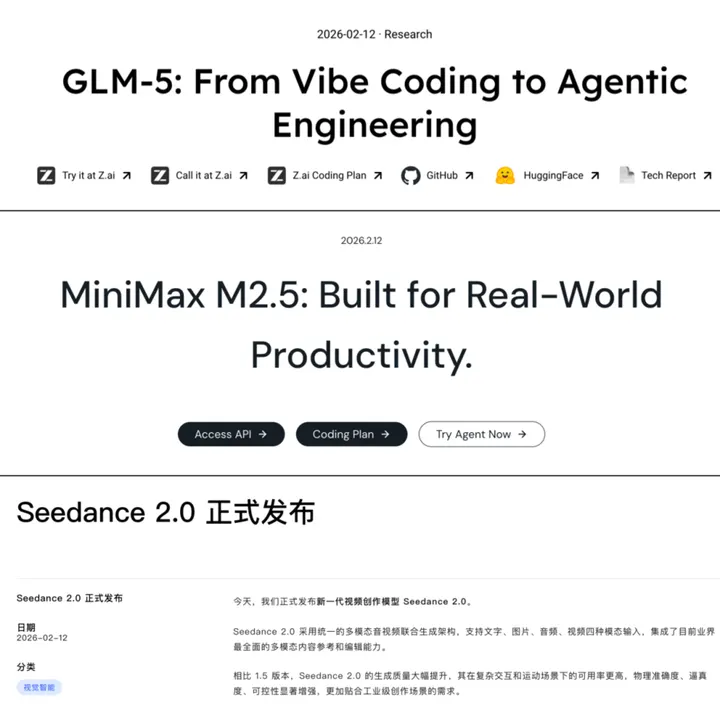
2月12日,智谱和MiniMax同一天发布GLM-5和M2.5,字节也推出了新一代视频生成模型Seedance 2.0。
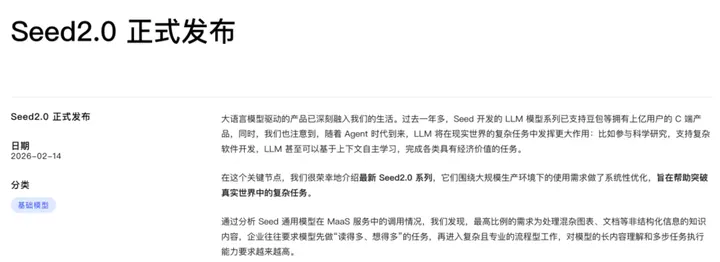
两天之后,字节又马不停蹄地发布了豆包Seed2.0系列,为春节送上更智能的豆包助手。
2月16日,又是除夕当天,阿里Qwen团队端出了Qwen3.5系列,首发3970亿参数的MoE模型;春节假期最后一天,2月23日,又一口气放出了122B-A10B、35B-A3B、27B等多个新版本。
几家公司几乎是你方唱罢我登场,加班加点地推出新模型,连除夕和假期最后一天都有人忙着上新。
相比之下,今年十一确实安静得有点反常。
倒也不是完全没动静——9月27日,MiniMax赶在节前上线了M3.1-Flash-Preview,我们也实测了这款模型。
但此前备受期待的DeepSeek V4.1 Pro依然没有亮相,豆包2.2也迟迟不见踪影。智谱、月之暗面、阿里、腾讯等厂商,同样没有在假期里掀起什么新的发布大战。
国内模型圈就这样难得安静了下来。
在那条讨论中国模型为何突然没动静的帖子下面,有网友解释,中国刚刚结束了一年中最长的公共假期之一。
“而现在,游戏重新开始了。”
他甚至已经列好了自己的节后愿望清单:DeepSeek V4.1 Pro(甚至V4.5)、GLM-5.5,以及Kimi-4。
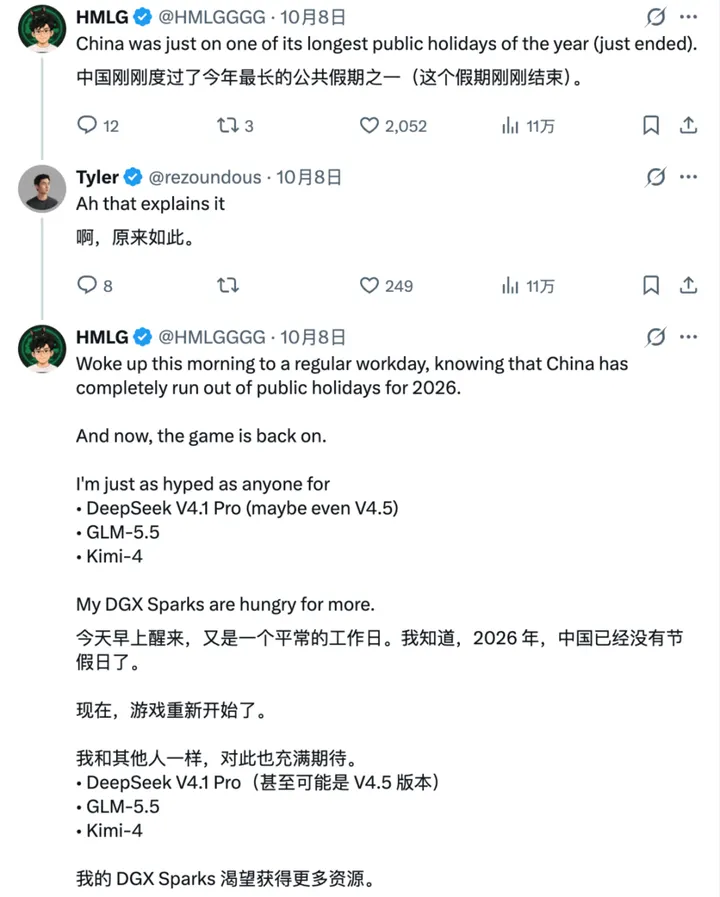
至少在海外模型爱好者眼里,中国大模型的“小长假”,也该结束了。
模型更新静悄悄,模型公司倒是没闲着。
9月28日、29日,DeepSeek Harness连续推出两个候选版本;到了10月3日,眼看着海外A厂刚刚开放Claude Code Mods,DeepSeek又在十一假期里上线了v0.2.1-alpha.1,加入了实验性的Claude Code Mods兼容,并支持让Agent自己创建插件。
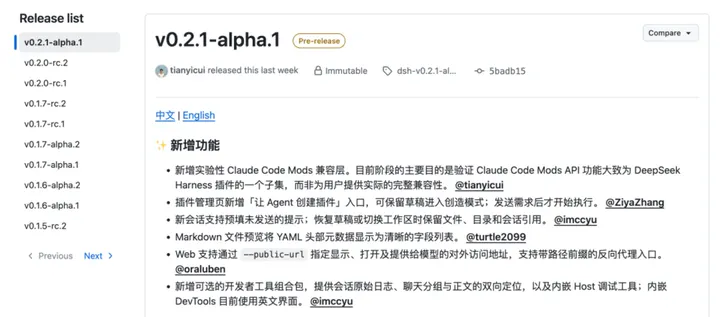
就在十一前一天,DeepSeek还在和华为一起折腾国产算力。
9月30日,DeepSeek宣布开源面向华为昇腾芯片的一批底层计算和通信组件,包括DeepGEMM-Ascend、DeepEP-Ascend等,同时推进基于128颗昇腾950芯片的超节点方案。
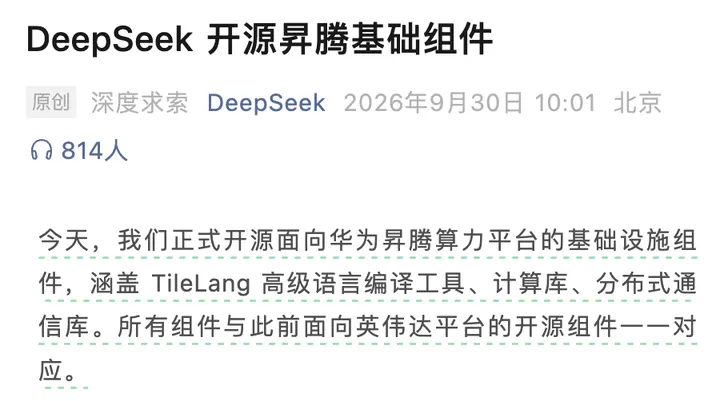
一边给Agent搭执行环境,一边给国产算力补工具链。大家等着DeepSeek发新模型,它却在忙着完善模型之外的东西。
智谱这边,忙的则是把模型卖出去。
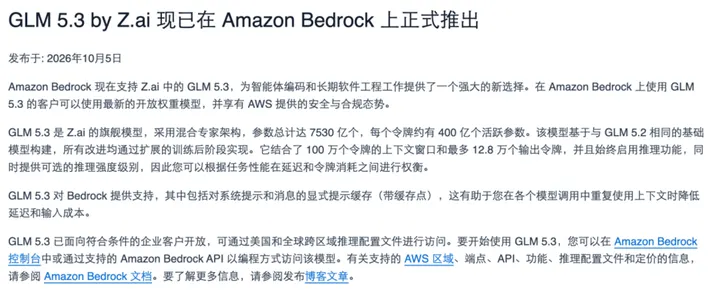
10月5日,AWS正式宣布,GLM-5.3上线Amazon Bedrock。
海外企业现在可以直接通过AWS的托管服务调用这款模型,不必自行部署推理环境。此前Kimi、DeepSeek等国产模型已经陆续进入海外云平台,智谱如今也加入了这场争夺全球企业客户的生意。
在资本市场上,这些AI公司同样没闲着。
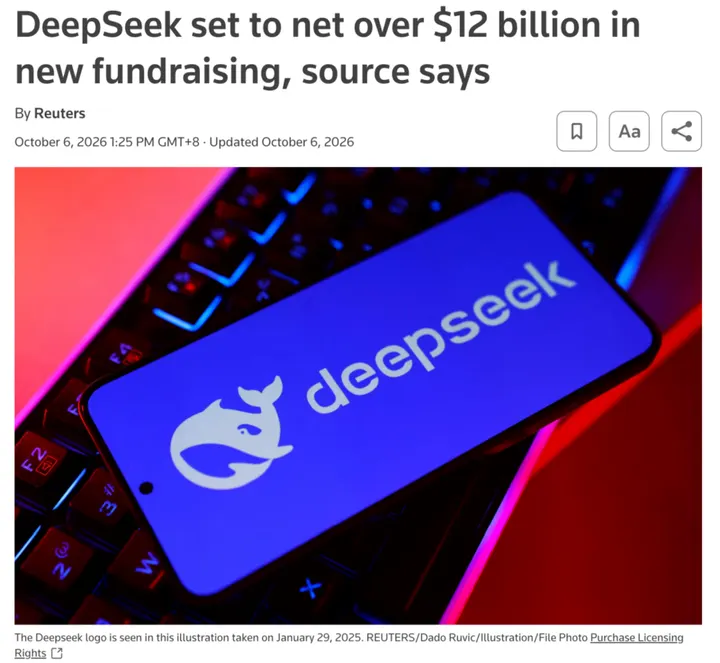
10月6日,路透社报道称,DeepSeek正在筹集超过800亿元的新一轮融资,最高可能达到1000亿元,目标估值约5000亿元,腾讯、宁德时代等企业据称参与其中。
另一边,Kimi离资本市场也更近了一步。
7月底,月之暗面就传出融资与赴港上市的计划。到了10月6日,彭博社进一步报道称,公司已经完成上市前最后一轮私募融资,估值升至约500亿美元,计划最快2027年第一季度在香港上市。
两条资本新闻虽然都还没有得到公司正式确认,但至少可以看出,模型公司的融资和上市进程,并没有跟着假期停下来。
原生AI公司忙着更新工具、寻找客户、筹集资金。那些”家底丰厚“的互联网大厂,则在继续给AI加码。
十一当天,《金融时报》披露,腾讯据报与甲骨文签订了价值约70亿美元、为期五年的海外算力租赁协议,涉及部署在东南亚数据中心的约10万颗先进AI芯片。
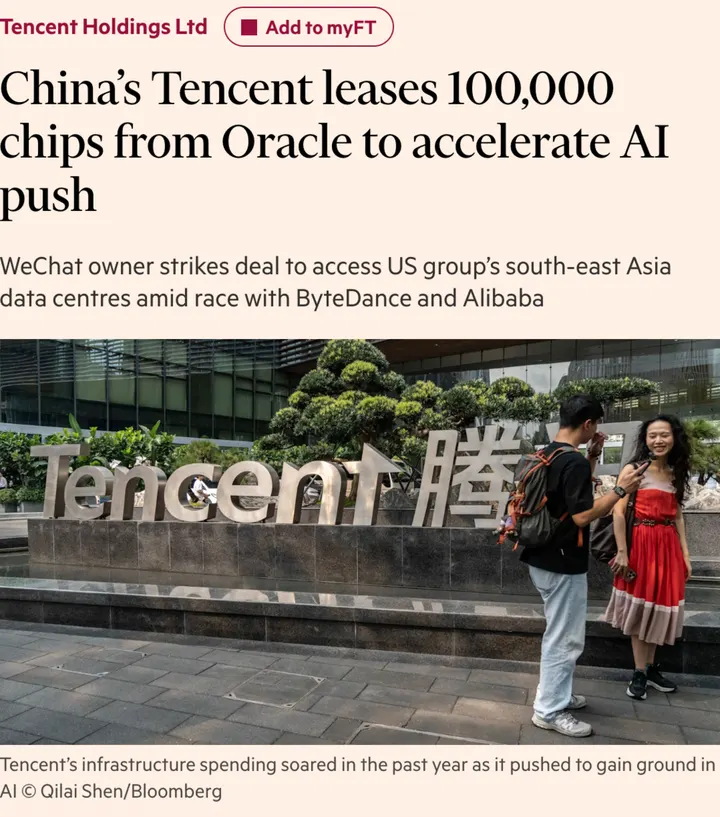
如果交易最终落实,相当于腾讯提前锁定了一大批未来训练和推理需要的算力。
10月8日,彭博社又传出消息,称腾讯正在考虑发行最多50亿美元的离岸债券,为AI和计算基础设施投入筹集资金。
阿里和字节也早已开始为下一轮AI竞争扩充家底。
9月22日,阿里在云栖大会上公布了新一代自研AI芯片真武V900,并提出到2032年将全球数据中心运营容量扩展至20GW以上;字节则在9月初筹集了296亿美元银团贷款,据报其中相当一部分资金将投向AI和基础设施建设。
这么一圈看下来,国内大模型厂商这个十一,忙的事情其实不少。只是这些动作没那么容易登上跑分榜,也少了几分新模型发布时的热闹。
不过,这些动作和模型发布并不冲突,所以问题还是那个问题:模型公司明明没闲着,怎么新模型就没动静了呢?
翻翻各家的发布记录,上一次让人眼前一亮的国产旗舰模型,似乎还是阶跃9月20日的Step 5 Preview和小米9月22日的MiMo-V2.6。
再往前看,9月10日,DeepSeek推出V4.1-Flash,首次展示新一代模型架构,但更受期待的V4.1 Pro尚未亮相;智谱8月14日发布GLM-5.3,随后又接连推出采用新基座的GLM-5.3-Flash和主打推理速度的FlashX;月之暗面的Kimi K3,则要追溯到7月中旬。
其他几家的情况也差不多。阿里8月初发布Qwen3.8-Max,字节6月推出Seed2.1系列,腾讯则在8月底开源混元Hy4 Preview。
几家厂商并没有闲着,专项模型和高速版本陆续推出,但最受关注的几款下一代旗舰始终没有全部到位。尤其是刚刚过去的十一假期,国内大模型市场没有迎来熟悉的扎堆发布场面。
更何况,有些本来就在等待名单里的模型,迟迟没传来新消息。
9月10日发布V4.1 Flash时,DeepSeek就在官方公告里提到了尚未上线的V4.1 Pro,还表示旧版V4 Pro接口将暂时切换至Flash,等待新的Pro版本推出。
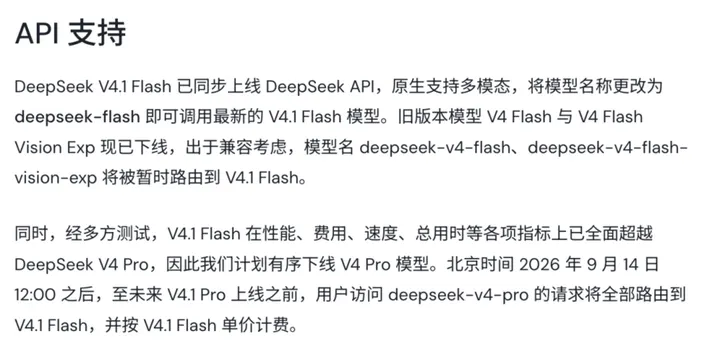
根据DeepSeek的“过节习惯”,不少人开始期待,没准十一前就出了。
结果,假期过去了,V4.1 Pro并没有亮相。
字节的豆包2.2更是已经让大家等了很久。
早在8月底,就有媒体报道称,原计划8月推出的豆包2.2将延期。据接近字节的人士透露,团队还想在编程、工具调用和Agent能力上继续打磨。
然后八月等到九月,九月又等到十一——就连谷歌都在十一前官宣了Gemini 4 Argon,豆包2.2都快成模型界的新一代戈多了。
当然,玩笑归玩笑,模型没有如期到来,可能有很多原因。
最简单的一种解释,就是大家真的放假了。
毕竟之前的假期有人发布模型,并不意味着AI工程师从此失去了享受法定假期的权利。
何况模型训练有自己的周期,评测、优化、上线也不是按日历推进的。要是恰好赶在节前准备好了,发个新模型给大家过节固然不错;要是还差点火候,总不能为了凑热闹,把没做好的模型硬端上桌。
而且,如今的大模型,想要再给大家来一点令人眼前一亮的升级并不容易。尤其是旗舰模型,参数继续增加、训练继续加码,最终还得落实到实打实的能力提升上。
海外几家大厂还在轮番刷新排行榜,国内厂商要是拿出一款新旗舰,结果跑分没涨多少,成本倒是上去了,恐怕也很难交差。与其赶在假期前发布一款没有多少惊喜的新模型,不如再攒一攒,厚积而“后发”嘛。
还有一种可能是,模型厂商现在要操心的事情,实在太多了。
前面提到的DeepSeek就是个例子。虽然V4.1 Pro没来,但DeepSeek Harness十一可没歇着,国产算力的底层工具也在加紧完善。
互联网大厂那边,似乎也在准备一场新的竞赛。
Muse爆火之后,个人Agent成为了最受关注的赛道,眼看着海外厂商已经开始给Agent安排工位、配联系方式,甚至组建团队,国内互联网大厂自然也有自己的盘算。十一前,腾讯Handy Bot、字节Spell接连被曝光,阿里千问也已经明确了个人Agent方向。
或许,国内AI厂商的竞争重心正在向Agent、产品和商业化转移一部分。这未必是坏事,毕竟模型最终要有人用,也要有人愿意付钱。
但模型能力终究还是智能的基础。放眼海外,Claude、GPT、Gemini、Grok还在轮番更新,模型能力和产品形态都在往前走。
如果说此前国内大模型凭借快速迭代和极致性价比,逐渐追上了全球第一梯队,那么现在,最需要警惕的就是好不容易追上的距离,又被重新拉开。
慢一点没什么问题,但在这个行业,一两个月已经足够创造好几条”斩杀线“。
现在,国内的AI工程师们大概也陆续回到了工位。
假期休完了,是时候拿出点新东西了。